从结果跳到结论
干预让人们摄入更少的盐,因此改善了健康。
一个面向答辩评估者的 AI 辅助工作台。
将分散的记录整理为可检查的证据,支持具体、可追溯的反馈。
01 / The Assessment Context
Viva 是通过对话检验理解与推理的口头评估。评估者会沿着回答继续追问:学生能否说明选择、回应质疑,并修正自己的判断?
下面以世界卫生组织(WHO)的减盐干预材料为背景的模拟答辩为例:学生需要说明研究结果能支持什么结论。研究测量的是菜品钠含量,学生却将它推论为个人健康改善。评估者的追问,让这处跳跃显现出来。
干预让人们摄入更少的盐,因此改善了健康。
实际测量了什么?还有哪些替代解释?
测量的是菜品中的钠含量,不能据此直接推断个人摄入与健康结果。
最初的过度推论、评估者的追问,以及学生随后的修正,共同构成了评价的依据。反馈既要解释这些表现与标准的关系,也要能回到具体回答,检查这份解释是否成立。
录音 / 转录 / 笔记
定位回答 → 理解语境 → 关联标准
有来源、可解释的反馈
02 / Research to Design Focus
文献梳理首先指出:口头评估中的判断依据难以完整留存,评价过程不够透明,反馈也常与具体回答脱节。随后邀请 11 位有答辩经历的参与者,通过访谈确认这些问题如何发生,并探索他们愿意接受哪些 AI 支持。
明确需要向参与者核实的问题。
追问具体经历、现有做法与困难。
逐段编码、比较,再聚合成主题。
编码表将原话、初始编码、聚焦编码和主题并置,使归纳过程可以被检查。以下节选呈现记录方式、反馈习惯与不同评估者之间的差异。
比较讨论对象、作用机制和后果,形成四组更高层次的问题。
答辩情境 · 评价价值
什么值得被评价?准备不确定 · 评估差异 · 反馈缺口
灵活对话在哪里带来困难?辅助角色 · 证据整理 · 反馈支持
哪些工作适合交给系统?人工权责 · 可靠性 · 隐私 · 可用性
怎样支持评估者保留判断?需要把回答、标准与反馈联系起来。
需要减少整理分散材料的工作。
评分活动让五种 AI 角色的接受边界变得清楚。最值得注意的不是哪个角色平均得分最高,而是双方分别在哪个环节表现出顾虑。
学生对 AI 担任提问者的接受度尤其低。这使直接介入答辩对话成为需要谨慎对待的方向。
校准涉及对标准与判断差异的理解。评估者对这一角色的现实可行性存在明显顾虑。
7 份学生视角与 5 份评估者视角回答;一位助教从两种角色作答,共 11 位独立参与者。两张图的纵轴含义不同。
03 / Behaviour into Design
目标行为是:答辩后检查来源,确认或修改标准关联,再用证据形成反馈。访谈显示,困难不只是“缺少一个功能”,还涉及记忆与注意力、工作条件,以及持续投入的意愿。
准备背景与标准
提问、聆听、记录
返回依据,解释判断
有评估者提到,记录时忘了写时间位置,之后便很难找回对应回答。
也有人把标准中的“理解良好”记进评价表,写反馈时却已想不起学生具体说了什么。
同时聆听、判断与记录,超出了零散笔记能承载的范围。
保留时间位置和连续回答;点击引用即可查看来源,并允许修改标准关联。
录音、标准手册和评分表分属不同工具,重新对照需要来回查找。
连续安排答辩时,上一位的笔记还没有补完,下一位学生就已进入;完整重听又意味着额外一轮工作。
工具和时间安排没有为复核提供合适的条件。
将转录、标准和候选集中在同一工作区,沿“记录 → 复核 → 反馈”连续完成。
评估者希望用具体依据解释判断,尤其在意见不一致或需要回应质疑时。
但在密集答辩后的疲劳状态下,整理容易被推迟,最后更多依赖对学生表现的总体印象。
复核带来的价值,容易被眼前的额外投入掩盖。
确认过的证据能够被引用和编辑,让每一次复核都成为具体反馈的一部分。
每条建议都需要可返回的来源、可修改的标准关联,以及明确的人工确认。让复核更容易完成,也让不同意系统变得容易。
04 / From Criteria to Evidence
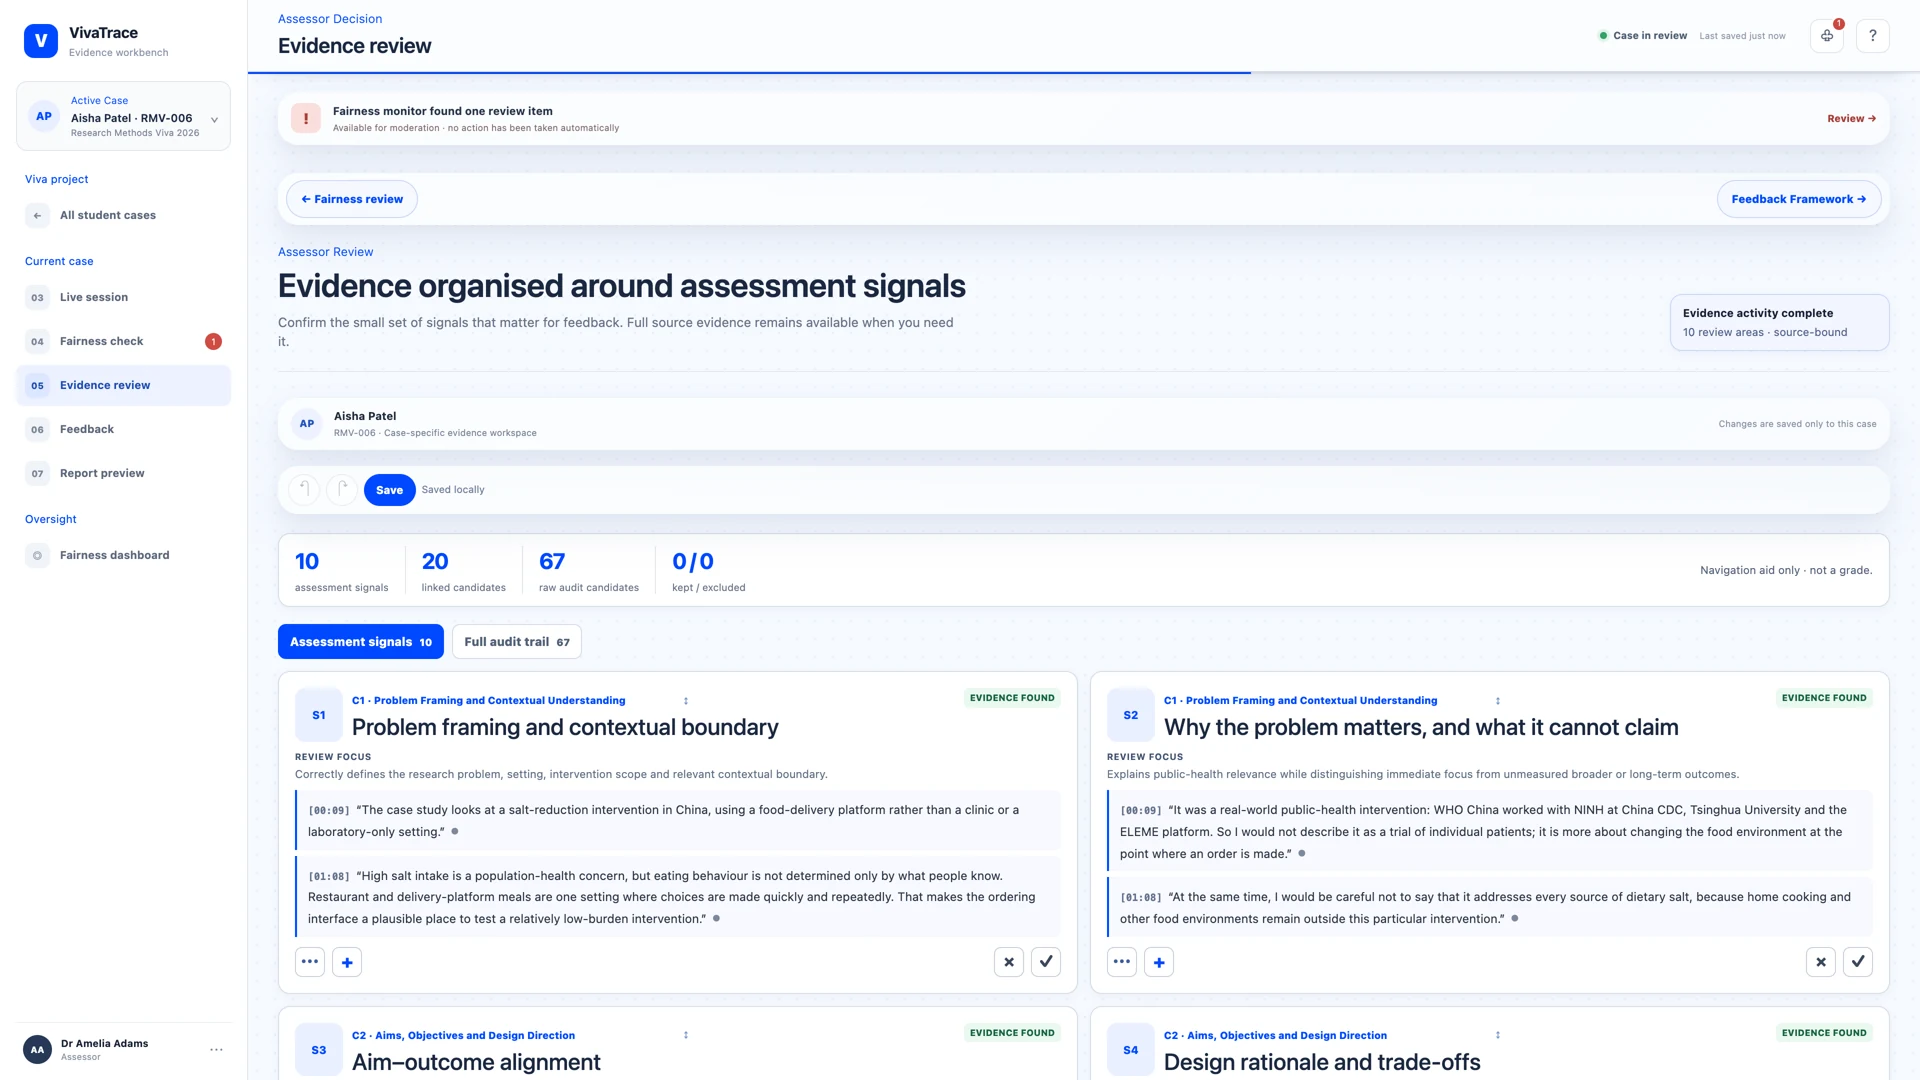
访谈中,教师会围绕评价标准判断关键表现,并据此记录和形成评价。如果把模型提取的每条候选都交给教师逐一审核,整理压力依然存在。为减少这部分负担、支持有效复核,设计在评价标准与候选证据之间增加了 Signals 这一层。
判断关注的是学生是否展现某种理解与推理,以及哪些回答支持这一判断。
相近片段可能反复出现,教师还要自行归类、比较,并检查是否遗漏重要内容。
将相关回答集中到少量复核单元中,同时保留完整候选记录,便于深入检查。
每个 Signal 说明“围绕这项标准,要关注学生的什么表现”,并关联一段或多段回答。系统根据标准提出这些线索,由教师确认或修改;审核时,可以保留、排除、重新分配标准,也可以补充来源。
按标准组织关键回答,集中判断其支持什么。
保留全部模型输出,检查重复、遗漏与不充分的推论。
当前演示案例的两层组织方式。Signals 不替代完整记录,也不直接产生等级或分数。
恰当解释结果、整合不同证据、识别不确定性与替代解释,并避免缺少依据的因果主张。
不同数据各自说明什么?结论是否超出了它们能支持的范围?
订单信息说明需求,经理问卷反映实施情况,钠检测说明菜品结果。
还有哪些因素可能解释结果?学生是否说明了这些限制?
餐厅与菜品差异、时间变化、顾客选择和实施不均,都可能影响结果。
两个关注点可以重叠,不是两项分数;找到关联片段,也不等于标准已经达成。示例中文为含义概述。
定位片段 · 建议关联 · 提示值得复核的互动
核对来源 · 修正解释 · 确认反馈与评价
05 / Interactive Prototype
跟随演示了解复核流程,或切换到自由体验,亲自查看来源、调整证据并编辑反馈。
迭代中将日常复核的 Signals 与完整候选记录分层,减少首屏阅读负担;项目配置共享,而每位学生的证据和反馈分别保存。
06 / System Design
即时性与可靠的说话人归属承担不同任务。系统将两者分开,再用来源位置、证据 ID 与人工复核状态连接后续流程。
约 8 秒窗口经 Whisper 转录后显示在界面中。短窗口可能截断句子或混淆说话人,因此不直接作为证据输入。
Pyannote 确定说话人和轮次边界,再精确截取音频交给 Whisper 重新转录。确认属于学生的稳定发言进入证据关联,并替换对应的临时文字。
项目统一配置案例背景、标准和 Signals;每位学生分别保留答辩记录与复核状态。后台服务支持整理,评估者在工作流中确认、编辑和排除,报告则保留返回具体来源的链接。
将项目背景、评价标准和稳定的学生回答一起送入模型。候选必须引用连续原文,不将评估者的措辞记作学生表现。
每条结果包含来源摘录、时间、主要标准、证据质量与关联理由,供后续复核。
标准分配、证据选择和复核决定按案例保存。Undo / Redo 使用浏览器内存中的快照;Save 保存当前状态。
研究版本另行采集交互事件,用于分析测试行为。操作日志与产品内的状态保存承担不同用途。
转录与说话人分离已接入原型;本项目未对其识别准确率进行独立基准评估。
07 / Model Selection
比较证据覆盖、标准匹配、响应时间与复核负担,再结合数据隐私和院校部署条件,确定模型的使用方式。
关闭思考;同一 WHO 模拟案例的 31 段学生回答、35 项基准证据,各运行 3 轮。延迟为单次请求均值,不等同于整场答辩处理时间。复核负担=候选数量 ÷ 匹配到的基准证据数量。
关闭思考的 GLM-5.2 在输出质量、等待时间与复核负担之间取得了最适合当前工作流的平衡,因此用于后续原型。相比 GLM-4.7 Flash,它在延迟接近的同时提供更高的覆盖率与标准匹配;相比 Qwen,它以部分覆盖率的取舍换来更短的等待与更少的复核候选。
答辩录音与学生回答涉及敏感的评估信息。让数据留在本地、减少外部 API 依赖,并适应院校的部署条件,是本地模型探索的主要动机。证据关联无需将回答发送到外部模型 API;同时也要考虑院校可用硬件、数据管理要求与维护条件。
96 GB 统一内存 · 量化模型
已验证本地证据关联;整套系统离线运行、院校接入与多人并发仍需进一步验证。选取可在现有测试硬件上运行的 GLM-4.7 Flash 与 Qwen3.6 量化配置,分别通过 Ollama 与 llama.cpp 接入同一证据关联任务。比较不止看能否运行,还要看本地方案在等待时间、证据覆盖与人工复核量之间如何取舍。
这组结果支持继续探索两种使用方式:低延迟配置用于答辩进行中的候选整理;覆盖更广的配置用于允许等待的答辩后复核。两者尚未在真实答辩中进行对照验证。
| 模型 | 思考 | 平均延迟 / s | 覆盖率 / % | 标准匹配 / % | 复核负担¹ | 请求数 |
|---|---|---|---|---|---|---|
| GLM-4.7 Flash · 本地 | 关闭 | 4.33 | 85.7 | 80.0 | 1.90 | 93 |
| GLM-4.7 Flash · 本地 | 开启 | 42.22 | 91.4 | 82.3 | 2.74 | 93 |
| Qwen3.6 · 本地 | 关闭 | 30.58 | 94.3 | 90.9 | 2.61 | 93 |
| Qwen3.6 · 本地 | 开启 | 255.47 | 91.4 | 81.2 | 2.28 | 31 |
| GLM-5.2 · API | 关闭 | 4.71 | 89.5 | 85.1 | 1.90 | 93 |
| GLM-5.2 · API | 开启 | 12.30 | 91.4 | 90.6 | 2.22 | 93 |
五组配置各运行 3 轮,Qwen 开启思考运行 1 轮。Temperature 0;最大输出 6,000 tokens;上下文 16,384 tokens。本地配置使用 M2 Max / 96 GB。¹ 复核负担为候选数量相对于匹配基准证据数量的比值。
延迟与请求数由保存记录复算。覆盖率、标准匹配与复核负担沿用已报告结果,逐项匹配记录尚未完整复核。结果仅适用于本次材料、配置与测试环境。
08 / Process Risk Review
这里的 Risk 表示值得回看的潜在线索,不代表某个问题或某位评估者已经被判定为不公平。系统以尽量不遗漏潜在风险为目标,高亮可能需要检查的片段;评估者再结合前后对话、提问目的与作答机会,决定是否存在问题。
被高亮,不等于不公平。例如,“我先打断你”可能是在合理控时或引导讨论回到主题。需要回看的,是打断发生的语境、目的,以及学生是否仍有充分解释的机会。
以下六组模拟对话展示不同的复核线索。对话是否存在问题,仍需结合完整语境判断,不能仅凭示例中的一句话下结论。
How did you approach tokenization, and what decisions did you make regarding punctuation and word boundaries?学生需要自己解释方法。回答薄弱本身不代表评估过程有风险。
Let's talk about tokenization. One thing that strikes me about historical newspaper text is that OCR errors and archaic spellings can really throw off a standard tokenizer — you get fragments where an apostrophe or a long-s character splits a word in unexpected ways. So the key question is whether you relied on spaCy's default tokenizer out of the box, or whether you did anything to handle those period-specific boundary issues.评估者先解释了错误产生的机制,再让学生回应。高亮后需检查:这是必要的背景说明,还是替学生提供了本应由其展示的关键推理。
需要结合评价标准和前后回答,判断核心推理由谁提供;仅凭问题长度或一句提示,不能认定评估不公平。
以上为模拟对话示例的英文原文,附中文解读。下方检测结果基于独立标注的 200 个受控模拟案例。
4 个学科背景
2 轮独立检测
直接风险事件检出 / 每类每轮 20 项
召回率基于每轮 60 项直接风险事件:91.7% / 90.0%。两轮的 80 个基线案例均未出现误报。结果反映模拟条件下的过程风险识别。
预置提示用于展示复核操作;检测表现采用下方独立实验结果。
80 个公平基线案例,加上 6 种条件各 20 个案例:标准机会缺口、挑战强度差异、合理适应性追问、实质性提示、问题相关性不明确、评估者主导。
后三类直接风险共 60 项,用于召回率计算。机会缺口供审查,挑战强度差异需要跨案例比较,合理追问作为负例。
实质性提示的识别最不稳定:两轮分别检出 16/20 与 14/20。是否由评估者提供了关键推理,需要结合前后对话检查。
第 1 轮:55 次正确检出、5 次漏检、2 次误报。第 2 轮:54 次正确检出、6 次漏检、0 次误报。
09 / Usability & Iteration
16 位新参与者通过远程任务体验完整流程,包含 10 位有评估经验者与 6 位无相关经验者。测试结合操作记录、出声思考与问卷,观察可用性与复核行为。
到达报告预览并完成问卷
满分 100 / 主观可用性
一人未进入项目总览
170 次保留之外,只观察到 6 次修改。高接受量可能来自合适的建议,也可能来自快速确认;需要进一步检查复核质量。
参与者留下开放回答
简短、可选回答的描述性归类同一人可以进入多个组,不代表全部 16 人的问题发生率。
认为自己能够质疑、编辑、拒绝或补充系统建议。
功能存在,不代表用户能发现它。整体控制感与具体操作困难可以同时出现。
有参与者不确定 Signals 的含义及其与标准的关系;也有人希望在进入答辩前,用示例检查配置。改进重点因此从“生成更多内容”转向“解释关联、验证配置、显露关键入口”。
更清楚地呈现 Criteria 与 Signals 的关系,检查使用者能否解释二者的联系。
改善返回总览与补充证据的入口,测试无提示时的发现与完成情况。
明确处理进度、部分结果与恢复路径,观察等待中是否能继续有效工作。
测试使用 SDIL 糖税模拟答辩,与前文 WHO 产品演示分别组织。参与者按任务指引操作,均未参加前期访谈或原型测试。
时间为中位数,包含阅读、讨论和系统等待;阶段存在重叠,不应相加。本次无对照组,结果支持流程可用性,尚不能量化工作量降低或反馈质量提升。改进方向来自开放回答的归纳。
10 / What Comes Next
VivaTrace
将研究发现落实为可操作的界面,再用真实的使用过程检验设计。AI 的价值,也体现在人能否理解、检查和修正它的建议。